注意:因为学习平台题目是随机,选择题选项也是随机,一定注意答案对应的选项,同学们在本页按“Ctrl+F”快捷搜索题目中“关键字”就可以快速定位题目,还是不懂的话可以看这个:快速答题技巧
一、2026年秋江苏开放大学神经网络与深度学习作业三单选题答案
1、在典型CNN⽹络AlexNet中,原始图⽚是⼤⼩为227*227的三通道数据,经过96个⼤⼩为11*11的卷积核卷积后得到96个⼤⼩为55*55的特征图,若padding=0,则卷积核的步⻓为多少?
A、4
B、1
C、2
D、3
正确答案:A
题型:单选题客观题分值5分难度:一般得分:0
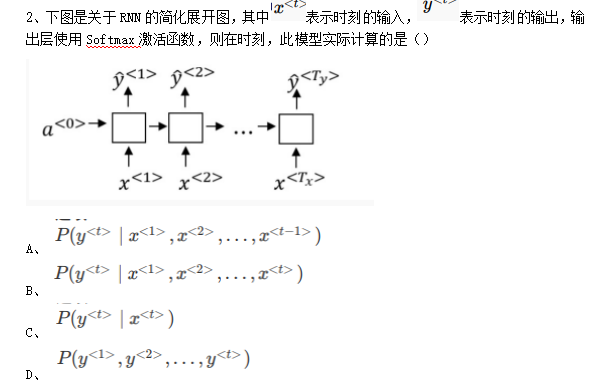
学生答案:C
3、对以下输⼊⼤⼩为(7,7)的数据,⾸先进⾏幅度为3的填充,设置滤波器⼤⼩为3*3,步幅为2,卷积运算输出结果的⼤⼩为?
A、4,4)
B、(7,7)
C、(6,6)
D、(5,5)
正确答案:C
4、以下关于神经⽹络的训练过程,描述错误的是?
A、【随机梯度下降】stochastic gradient descent:“随机”代表在梯度下降中随机初始⼀个学习率,并不断尝试多个值,寻求最好的结果
B、【计算梯度】为了减⼩mini-batch的损失函数,需要求出各个权重参数的梯度
C、【更新参数】梯度反⽅向表示损失函数的值减⼩最多的⽅向,将权重参数沿梯度反⽅向进⾏微⼩更新
D、【mini-batch】从训练数据中随机选出⼀部分数据,这部分数据称为mini-batch,我们的⽬标是减少mini-batch损失函数的值。
正确答案:A
5、以下关于神经⽹络中卷积运算的说法,正确的是?
A、若卷积运算输⼊数据为⼆维形状,则滤波器的⻓和⾼⼤⼩必须相等
B、若卷积运算输⼊数据为三维形状,输⼊数据和滤波器的通道数要设为相同的值
C、若卷积运算输⼊数据为⼆维形状,则输⼊数据的⻓和⾼⼤⼩必须相等
D、若卷积运算输⼊数据为三维形状,则输⼊数据和滤波器的⻓和⾼均要设为相同的值
正确答案:B
6、在⼀个神经⽹络⾥,知道每⼀个神经元的权重和偏差是最重要的⼀步。如果以某种⽅法知道了神经元准确的权重和偏差,你就可以近似任何函数。实现这个最佳的办法是什么?
A、以上都不正确
B、随机赋值,祈祷它们是正确的
C、赋予⼀个初始值,检查与最优值的差值,然后迭代更新权重
D、搜索所有权重和偏差的组合,直到得到最优值
正确答案:C
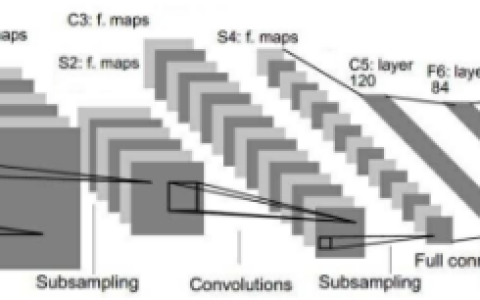
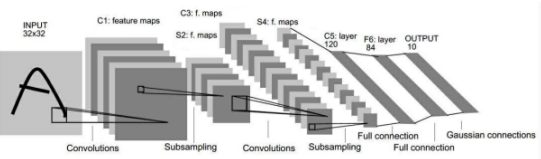
7、有Lenet的结构如图所示,输⼊数据⼤⼩为⼤⼩单通道图⽚,在C1卷积层使⽤个⼤⼩为的卷积核进⾏卷积,,步⻓为。在S2池化层使⽤的卷积核进⾏步⻓为2的平均值池化。在C3卷积层使⽤个⼤⼩为的卷积核进⾏卷积,,步⻓为。在S4池化层使⽤的卷积核进⾏步⻓为2的平均值池化。扁平化后接⼊C5全连接层,其中C5全连接层的输出⼤⼩为120,请问C5全连接层的输⼊是多⼤?
A、1024
B、400
C、300
D、784
正确答案:B
8、在进⾏卷积层的处理之前,有时要向输⼊数据的周围填⼊固定的数据,这称为填充(padding)。对⼤⼩为(4,4)的输⼊数据进⾏幅度为3的填充,则输⼊数据⼤⼩变成多少?
A、(10,10)
B、(12,12)
C、(7,7)
D、(15,15)
正确答案:A
9、有如下结构RNN,关于的计算正确的是?
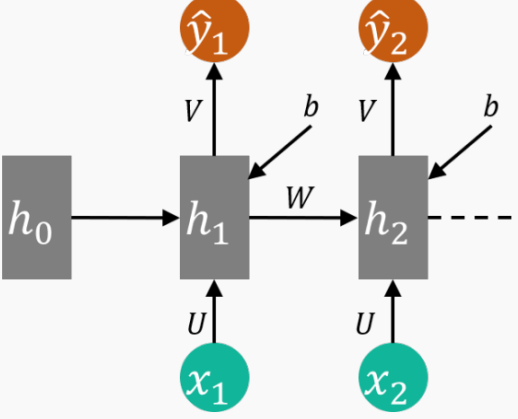
A、h2=f(Wh1+Ux2)
B、h2=f(Ux1+Ux2+b)
C、h2=f(Wh1+Ux2+b)
D、h2=f(Ux2+b)
正确答案:C
10、下⾯哪⼀种优化⽅法属于⾃适应学习率的优化算法?
A、AdaGraD
B、SGD
C、Nesterov Momentum
D、Momentum
正确答案:A
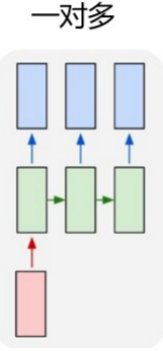
11、以下场景中适合采⽤⼀对多结构RNN的是?
A、情感分析
B、基于帧粒度的视频分类
C、⽣成图⽚说明
D、机器翻译
正确答案:C
12、多义现象可以被定义为在⽂本对象中⼀个单词或短语的多种含义共存。下列哪⼀种⽅法可能是解决此问题的最好选择?
A、随机森林
B、强化学习
C、以上所有⽅法
D、卷积神经⽹络
正确答案:D
二、2026年秋江苏开放大学神经网络与深度学习作业三多选题答案
1、下⾯关于随机梯度下降法(SGD)的叙述,正确的是?
A、SGD在收敛过程中波动较⼤
B、参数更新公式中的学习率需要随机选取
C、使⽤参数的梯度,沿梯度⽅向更新参数,并重复这个步骤多次
D、SGD形式简单,并且容易实现
正确答案:A;C;D
2、以下关于CNN中池化的说法,正确的是?
A、池化对输⼊数据的微⼩偏差具有鲁棒性
B、通常池化的窗⼝⼤⼩会和上⼀步卷积操作的步幅设定成相同的值
C、经过池化运算,输⼊数据和输出数据的通道数不会发⽣变化
D、池化只是从⽬标区域中取最⼤值(或平均值),所以不存在要学习的参数
正确答案:A;B;C;D
题型:多选题客观题分值5分难度:一般得分:0
3、VGGNet是⼀种典型的深度卷积神经⽹络,被⼴泛应⽤在⼤规模数据集的分类问题上。⽽在实际应⽤中,VGGNet中的训练层深度最多不会超过19层,请问这是为什么?
A、仅为了避免麻烦
B、梯度消失使得优化变得困难
C、训练时间过⻓
D、参数量爆炸
学生答案:B;C;D
4、下列哪些是CNN中卷积操作的特点?
A、等变表示
B、稀疏连接
C、参数共享
D、简化运算
正确答案:A;B;C
5、对于发⽣过拟合的原因,下列叙述正确的是?
A、训练数据集量太⼩
B、模型拥有⼤量参数
C、训练数据集量太⼤
D、模型表现⼒差
正确答案:A;B
6、下列哪些是批标准化(Batch Normalization)算法的优点?
A、可以不那么依赖初始值
B、可以降低噪声
C、可以抑制过拟合
D、可以增⼤学习率
正确答案:A;C;D
三、2026年秋江苏开放大学神经网络与深度学习作业三简答题答案
题型:简答题主观题分值10分难度:简单得分:10
1、用你自己的话说明RNN为什么比普通前馈网络更适合处理序列数据;写出RNN前向传播的基本思路,并说说LSTM/GRU相比简单RNN的一个主要改进点是什么。
正确答案:
普通前馈神经网络每层的输入之间相互独立,网络没有记忆能力,每一次计算都不会保留上一步的信息。而序列数据前后元素存在很强的依赖关系,后面时刻的结果往往受前面内容影响,前馈网络无法捕捉这种时序关联。RNN在结构上增加了循环连接,能够保存历史时刻的信息,因此比普通前馈网络更适合处理序列任务。
RNN前向传播的核心思路就是按时间顺序一步步计算。每一时刻,网络接收两部分输入:当前时刻新的数据,以及上一时刻产生的隐藏状态。隐藏状态就相当于网络的“记忆”,储存着之前序列学到的信息。将当前输入和上一刻记忆共同运算,经过激活函数得到当前时刻新的隐藏状态,再利用该隐藏状态计算这一时刻的输出;随后把新的隐藏状态传给下一时刻,循环往复,直到整个序列全部计算完成。
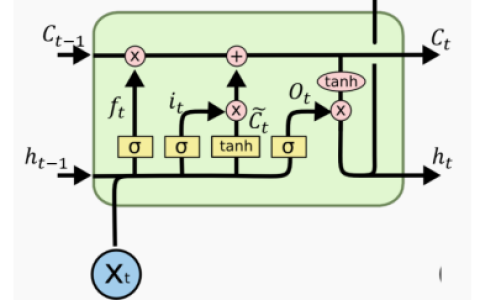
但是简单RNN存在严重的梯度消失或梯度爆炸问题。当序列较长时,早期时刻的信息会随着时间推移不断衰减,网络很难学习到距离较远元素之间的依赖关系。而LSTM和GRU最主要的改进就是引入了门控机制。通过遗忘门、输入门、输出门等结构,自主控制哪些历史信息需要保留、哪些信息需要丢弃,有选择地把远距离的重要信息长期保存在细胞状态中。以此缓解长序列训练时的梯度消失问题,更好地捕捉长距离的时序依赖。
 未经授权,禁止转载,发布者:形考达人
 ,出处:https://www.xingkaowang.com/38764.html
免责声明:本站不对内容的完整性、权威性及其观点立场正确性做任何保证或承诺!付费为资源整合费用,前请自行鉴别。
免费答案:形考作业所有题目均出自课程讲义中,可自行学习寻找题目答案,本站内容可作为临时参考工具,但不应完全依赖,建议仅作为辅助核对答案的工具,而非直接使用!